数据生成指南
长文。按五个问题逐一回答,每条结论附代码位置、参数和实测数字。
Simons 是 Abel-ai-lab 开源的时间序列基础模型(patch-32 Transformer,25M / 60M / 178M / 297M 四个规模)。
它的训练前两个阶段只用合成数据,后两个阶段打包后的行里仍有 40% 是合成的。合成数据在训练进程里在线生成、用完即弃,没有离线数据集。
这一节根据 src/simons/synth 的源码与 configs/*.yaml,讲清这些数据怎么生成、怎么进入训练。
长文。按五个问题逐一回答,每条结论附代码位置、参数和实测数字。
流程图。从族配额到进 loss 的 13 步,附 18 个族的权重、6 种机制和观测效应总表。
四个训练阶段 × 四种模型规模怎么用合成数据,一行 batch 长什么样,协变量角色怎么分配。
18 个生成族,按原理分 6 大类:统计 / 谱方法、非平稳、结构化 / 因果、重尾 / 间歇、机理仿真、日历。不耦合的单变量行、耦合组成员的自身序列和 driver 底料都来自同一次 draw。例外只有三处:coint / event 机制的 driver 是随机游走与冲击序列;阶段 2 的效应行用独立的 SynthBases;阶段 3/4 的协变量 pass 以真实序列为底。
没有按质量挑选:族配额按权重确定性拆分,整体打乱,每条序列只用一次。有增强:draw 的最后一步让 40% 的行经过 1–2 类变换(mix / season / filter / lattice)。噪声、单位、左截断、缺失这些观测效应在耦合之后才加。
池里一半的行被切成 2–16 个成员的组,每组均匀抽 6 种机制之一(identity / mix / lag / coint / func / event)。成员 = √ρ · 变换后的 driver + √(1−ρ) · 自身序列。延迟和几何分布滞后在频域里一次完成,τ 最大 256 步,生成时多出 256 步预热再裁掉。合成成员天然等长;不同的观测起点由组内共享的左侧截断来模拟。
没有拒绝采样,用多少由配额决定:阶段 1/2 整个 batch 都是合成,阶段 3/4 打包后最后 40% 的行换成合成。任务是对每个 patch 预测下一个 patch 的 9 个分位数,并随机遮挡连续的上下文 patch。阶段 2 起部分耦合组被分配协变量角色,目标成员末端被遮挡。后处理是 post 的观测效应;真实数据的那套增强不作用于合成行。
没有。模型输入只有数值和观测标记,没有时间戳、起始时间或频率标签。频率只隐含在各族抽取的周期库里,个别族(如 calendar、queue)内部会抽每天步数和相位。
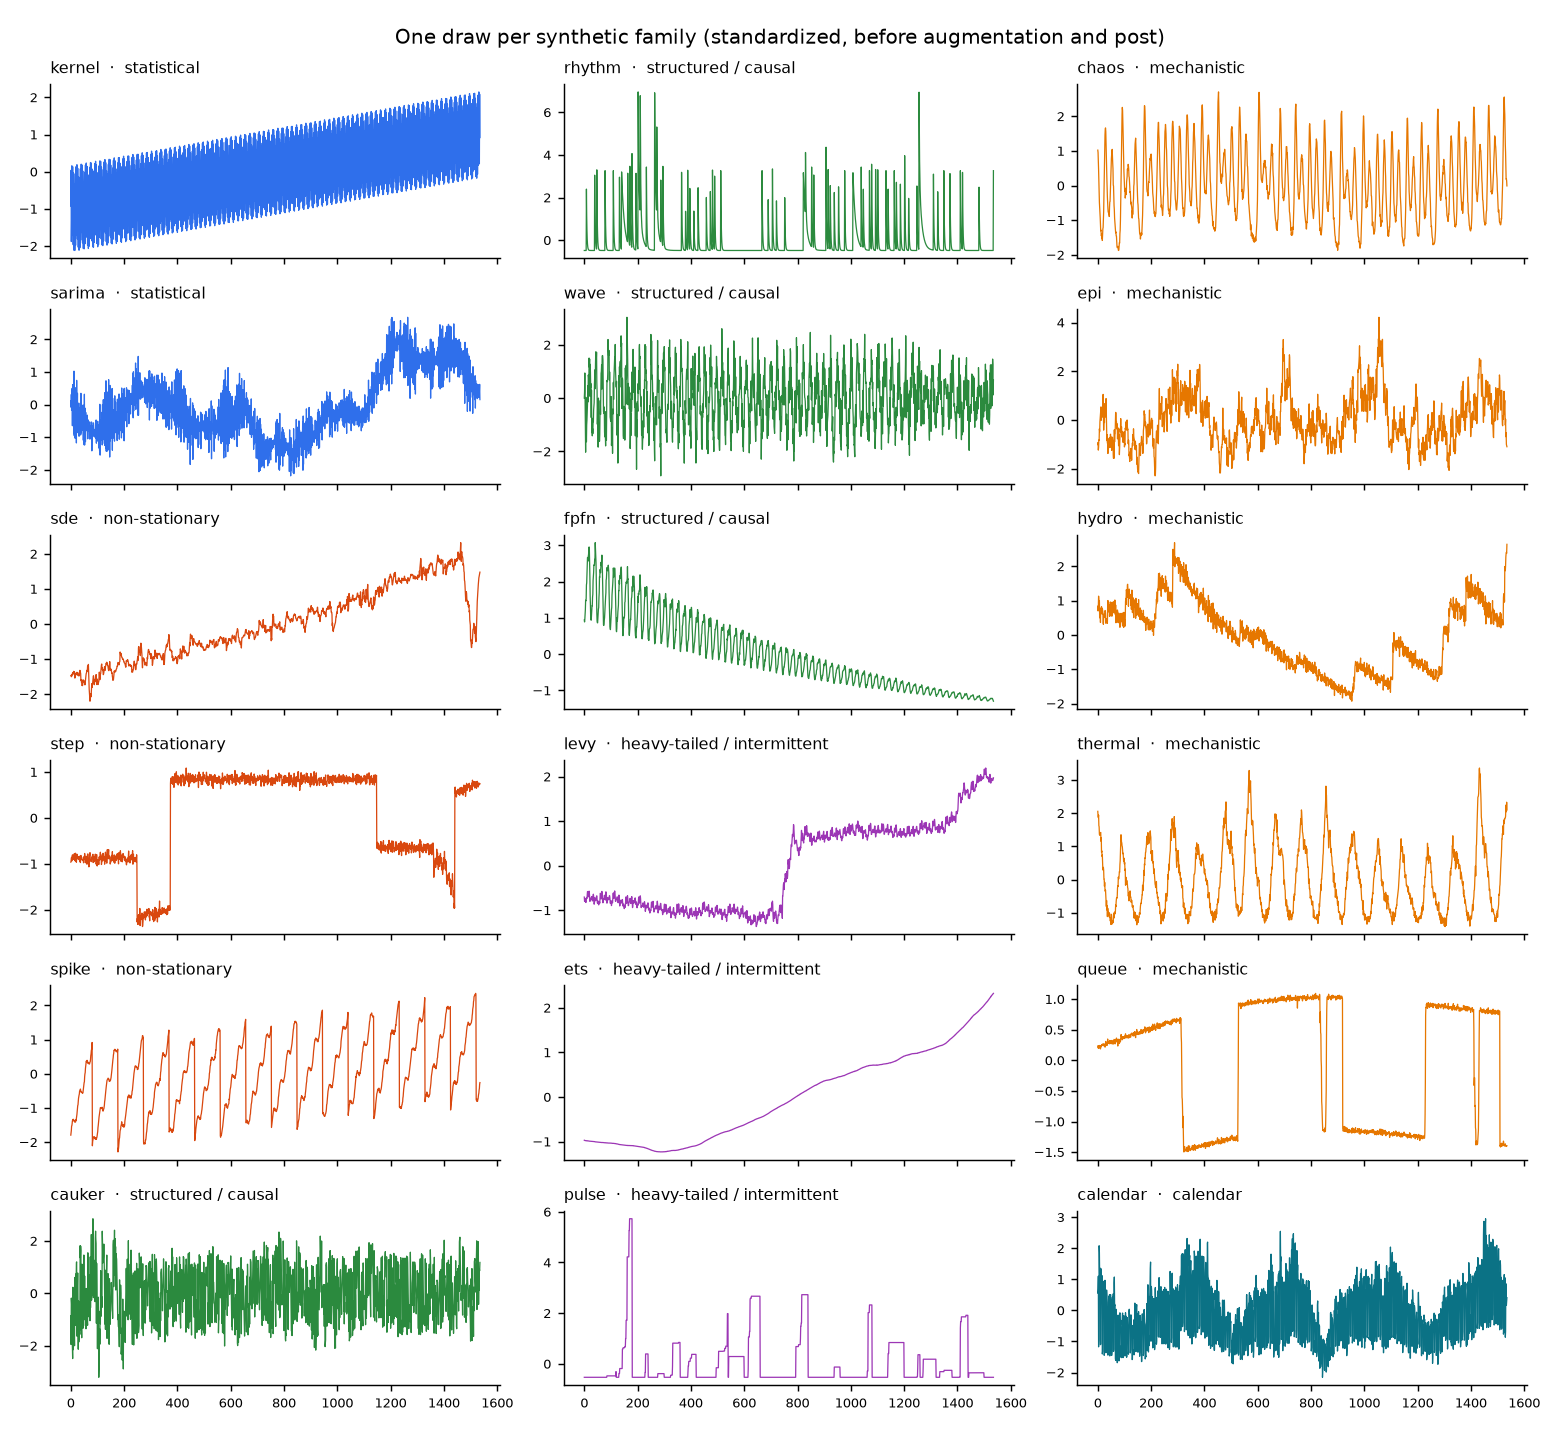
内容依据 Abel-ai-lab/Simons 的
src/simons/synth/、src/simons/training/ 与 configs/*.yaml 整理;图由 make_figures.py 生成。